武汉沙淘金数据治理专家解读--扫描PDF图片表格OCR数据抽取有哪些常见难点?
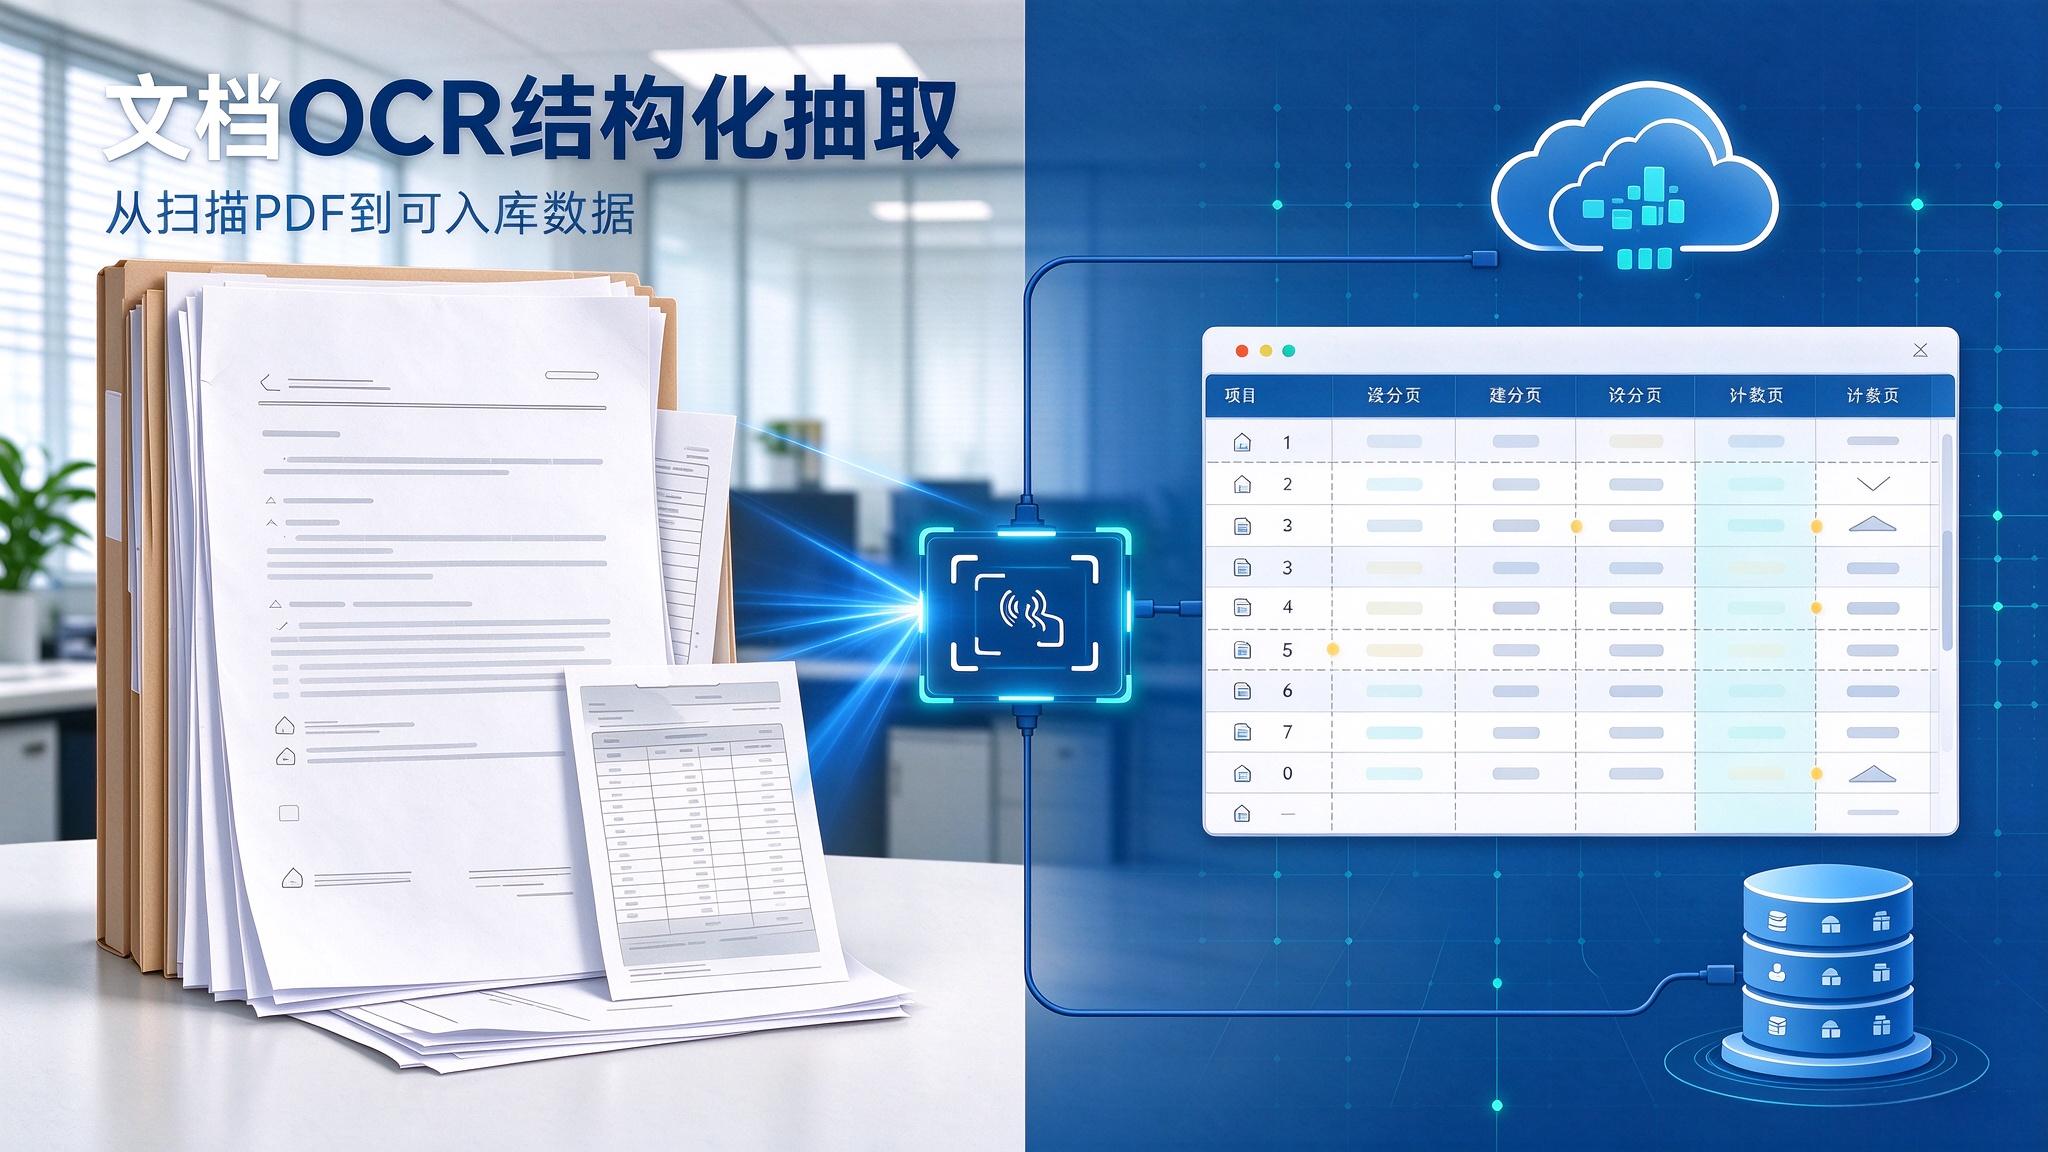
很多企业保存的历史档案、合同、单据都是扫描PDF或者图片格式,无法直接复制里面的表格文字,需要依靠OCR技术抽取结构化数据。但单纯使用通用OCR工具处理,识别结果往往达不到入库标准,里面存在不少难以规避的技术难点,了解这些问题,才能合理规划文档数字化项目。
一、扫描文档OCR抽取高频难点
1. 纸张质量问题:旧档案字迹淡化、折痕、污渍、底纹,会造成文字漏识别、错识别;
2. 表格结构错乱:扫描倾斜、表格线条断线,识别后单元格错位,行列混淆;
3. 混合版式:一页文档同时包含文字、表格、印章、备注,OCR容易混淆不同内容;
4. 多语种、特殊字符:单据中的特殊符号、大小写、编号容易识别出错;
5. 格式丢失:识别出来之后,文字全部平铺,丢失原有表格结构,需要重新整理。
很多企业直接使用免费在线OCR批量处理大量档案,拿到手的数据依然需要花费大量人工整理,整体效率很低。
二、对应的工程化处理方案
1. 图像预处理:对扫描图片做纠偏、去底色、降噪、增强文字对比度,提升识别基础质量;
2. 版面分析:区分文档内纯文字区域、表格区域、图片印章区域,单独解析表格单元格;
3. 分层识别:表格区域单独识别,保留行列结构;普通文本单独提取;
4. 规则校验:通过业务规则校验编号、金额、日期等字段,标记识别异常内容;
5. 人工复核:识别结果完成后,对高风险单据、识别置信度低的内容安排人工校对。
三、项目落地建议
少量文档,普通OCR工具可以临时使用;大批量档案、合同、表单数字化项目,单纯依靠通用OCR很难交付合格结构化数据。需要图像预处理、版面解析、人工校对整套流程。如果内部人员缺少文档处理经验,大批量扫描资料抽取工作可交给专业服务商。
关于我们
武汉沙淘金信息技术有限公司(品牌:筛斗数据 shaidou.net),由湖北十团网络科技孵化,专注数据清洗、多源数据治理、PDF/OCR文档抽取、地址标准化、脏数据外包服务,面向政务、电商、制造、法律、医疗、金融行业提供数据处理落地项目,全程遵循《数据安全法》保障客户原始数据安全。
地址:湖北省武汉东湖新技术开发区高新大道766号光谷总部中心T2栋20层2006室
十堰服务基地:十堰市北京北路99号万达广场B栋7层
联系电话:15527881935
官网:www.shaidou.net